Neural Collage 論文 ざっくりまとめ
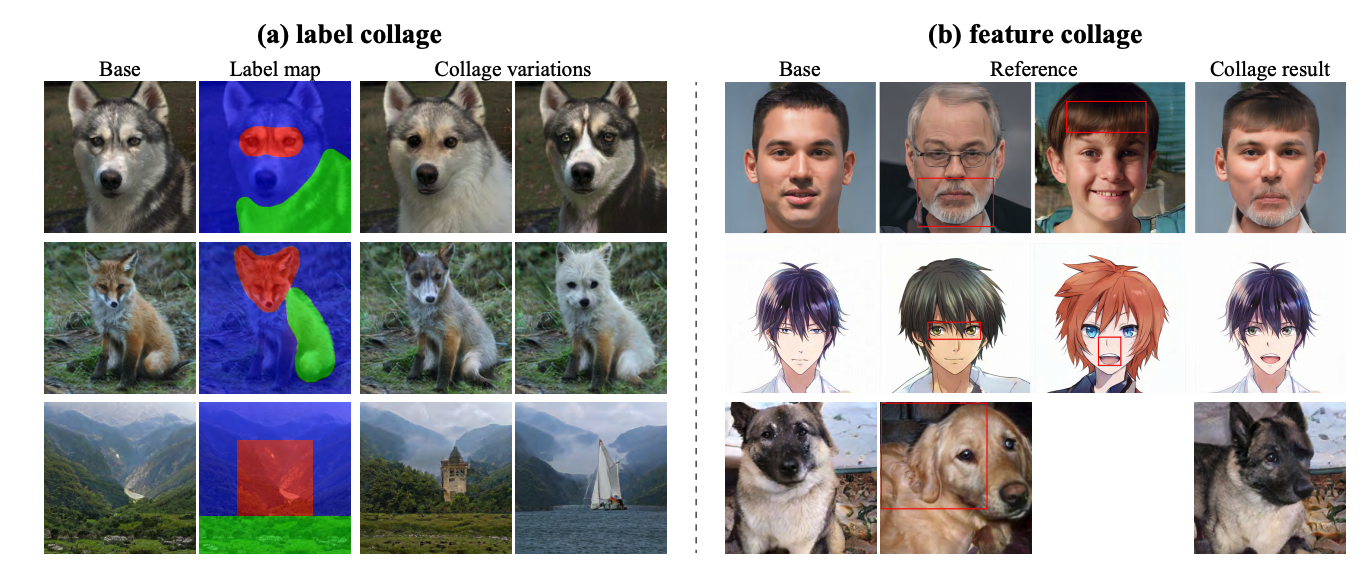
学習済みのドメイン内において自然なコラージュ画像を作ることができる
この前読んだStyleGANにもそのまま適用できるようで激アツ
Conditional Normalization Layer (先行研究)
- 普通のBatch Normalizationとは異なり、正規化後の特徴マップ$x$に対して施すAffine変換$y = \gamma x + \beta$において、$\gamma$と$\beta$がパラメータではなくて、クラスラベルのAffine変換から求まる
- つまり入力のクラスごとに正規化のパラメータが変わる
- これにより各層に入力するクラスラベルの情報を入れられるので、全体的には形は犬だけど細かなテクスチャは猫みたいなことができる?
- ラベル化されたデータセットが必要
- StyleGANで用いられているAdaINもこれのfamilyということになっている
- ラベルはないが、各層ごとにスタイルを注入できるから?
今回の論文特有の手法
Spatial Conditional Batch Normalization(sCBN)
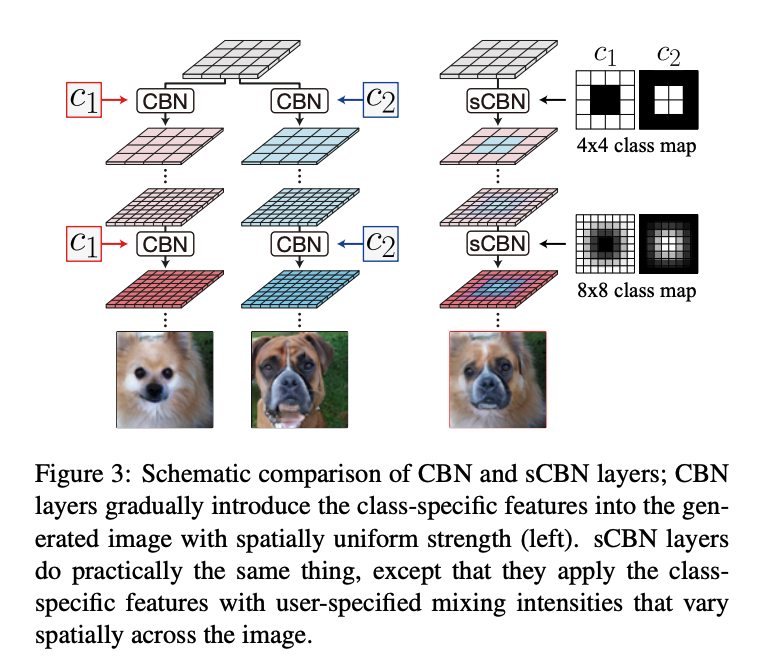
- 上述CBNの進化形で、ラベル情報を注入する層のみならず位置もいじれる
- CBN(図左)では各層にクラスラベル(ここでは"ポメラニアン"と"ブルドッグ")を注入することで好きな犬種を生成できていた
- sCBN(右)ではユーザーがクラスごとのヒートマップを指定することで、顔はブルドッグだけど毛並みはポメラニアンみたいな画像が生成できる
- やっていることは基本的に上で出てきたクラスごとの$\gamma$と$\beta$の指定したヒートマップに対する重み付き和を取っているだけ(上の例では顔の部分だけブルドッグの重みがでかかった)
Spatial Feature Blending
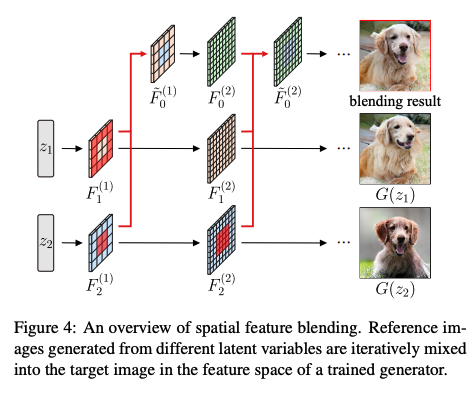
- sCBNでは画像の一部を別のラベルに変換する、ということを実現したが、ここでは画像の一部を別の画像に差し替えることができる
- こちらもやってることはとても簡単で、元画像と混ぜたい画像の潜在変数をそれぞれ用意し、両方ともGeneratorに入れながら各層で指定したヒートマップによる重み付き和を取りながら進めていく
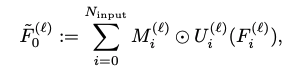
- $l$番目の層における特徴マップの計算が上式
- $i$は混ぜる画像のインデックスに対応し、$F$が特徴マップ、$M$が画像ごとのヒートマップ(どの部位を使うか)
- $U$がスライドやリサイズするための行列(例えば画像Bの目の部分を画像Aに移植したい場合、画像A, Bの目の位置が違う時にこれで調整ができる)
- つまり$U, M$はユーザーが指定する
Manifold Projection
- 上述のSpatial Feature Blendingは画像の潜在変数があることが前提となっている
- モデルが生成した画像ではない実際の画像に適用するには、各画像を潜在空間に写像する必要がある
- この論文ではgenerator, discriminatorの他に新たにEncoderを学習させることでこれを実現している
- Encoderに一回入れるだけでは精度がイマイチということで元画像との類似度を損失としてbackpropagationにより潜在変数を調整していくようだ
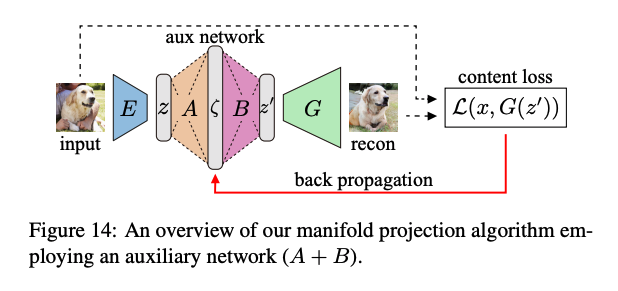
- 推論時に何度もbackpropagationするのは大変、ということでEncoder一つでは飽き足らず、上図A, BのようにさらにAuxiliary Networkを加えている
- Aux Networkでは潜在変数$z$ではなく、その次元を拡張した$\zeta$にbackpropすることにより、より早く元画像に近づけることができるとのこと
- ただしこのためには$G, D \to E \to A, B$という三段階の訓練が必要
モデルの応用法を考える
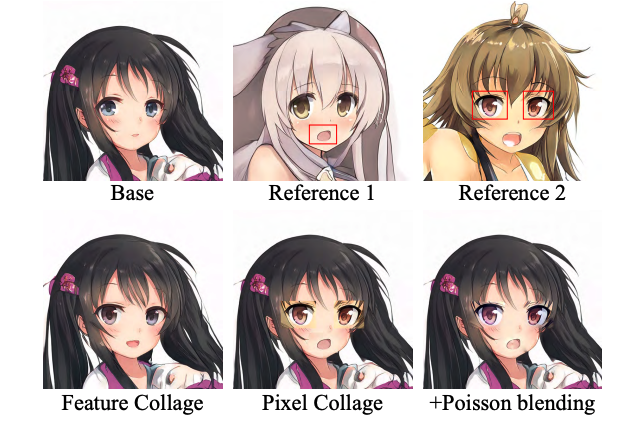
- 特にSpatial Feature Blendingに関してはおそらく任意の訓練ずみ画像生成GANに適用できそうだ
- こんなんで本当に上手くいくんだろうか
- 論文ではStyleGANへ応用した例も載っており、アニメ画像のコラージュでも使えることが示されている
- 上図左下が、StyleGAN+今回の手法を使って上3枚を合体させた結果
- 顔パーツのカスタマイズ
- 服装、ポーズの変更?
- 自然な口パクに関しては、もともと口の閉じている画像に空いている口を移植して連続変化させればいいのではないか
- ちょうど上の例でも口の形を変えている
- 連続変化はヒートマップの値を滑らかに変えればいいのか?
- githubのREADMEに連続変化させるgifがあった
- Manifold ProjectionについてはStyleGANではDiscriminatorの全結合層を除いたモデルがそのまま使える説がある
- 学習法的に$D = G^{-1}$になっていることが期待される(要検証)
- 仮にManifold Projectionが不要だった場合、追加の学習は一切不要
- 実装に関しては、githubにあるのは今回の手法をSNGANに適用したもので、犬をいじることしかできない
- StyleGANの公式実装を読み解いて改造するしかなさそう
- やること自体は各ブロックに特徴マップの重み付き和をとる部分をたすだけなので難しくはない
- StyleGANで用いているAdaINはCBNのfamilyだからsCBNも適用できるぜ!みたいなことが論文にあったが、CBNでいうクラスラベルはAdaINでいうところのstyle画像のlatentなので、sCBNを頑張ったところでSpatial Feature Blending以上の効果は得られなそう
- 口あり、なしのラベルつきのBigGANとかを訓練して、それのsCBNによって口を自然に動かす、というのも考えられる
- これだとManifold Projectionが本質的に不要
- 口あり、なしのラベルつきのBigGANとかを訓練して、それのsCBNによって口を自然に動かす、というのも考えられる
